Projet livré
Prédire sans entraîner
CatBoost contre Kumo-Tabular sur la consommation énergétique des bâtiments de Seattle : un modèle de fondation tabulaire semble faire mieux sans entraînement, pour 25 secondes par appel. Quatre expériences pour vérifier, et ce que ça dit des usages, du coût et de ce qui reste au métier.
· Période : 8 → 18 oct. 2026 · 17 min de lecture
- Machine Learning
- Modèles de fondation tabulaires
- MLOps
- CatBoost
- Déploiement
Pour le projet 5 de ma formation AI Engineer, je devais déployer un modèle de machine learning en production : une API, des tests, une base, du suivi. Le modèle prédit la consommation d'énergie et les émissions de CO2 des bâtiments non résidentiels de Seattle. J'ai entraîné un CatBoost, puis je l'ai comparé à Kumo-Tabular, un modèle de fondation tabulaire de NVIDIA qui ne s'entraîne pas : il prédit à partir d'exemples qu'on lui donne à chaque appel. Sur ce jeu de données, il semble faire mieux, pour 25 secondes par appel. J'ai ensuite mené quatre expériences pour vérifier mes hypothèses : elles nuancent nettement ce premier résultat. Voici ce que j'ai mesuré et ce que j'en retiens.
- R² de Kumo-Tabular sur l'énergie, sans entraînement, contre 0,24 pour CatBoost
- 0,45
- un seul bâtiment, un data center, porte toute cette avance : sans lui et sans le plus gros site industriel, CatBoost repasse devant
- 1 / 310
- pour une prédiction Kumo sur CPU (4 threads), contre 0,8 ms pour CatBoost
- 25,5 s
- pour 1 000 prédictions Kumo en un seul appel : le coût vient du contexte, pas du nombre de lignes
- 42,5 s
- d'erreur sur les émissions avec un contexte mal construit : pour Kumo, le contexte joue le rôle du modèle
- × 528
- lignes de contexte : CatBoost progresse encore, Kumo plafonne et coûte presque 4 fois plus cher qu'à 1 236
- 4 700
Le projet livré
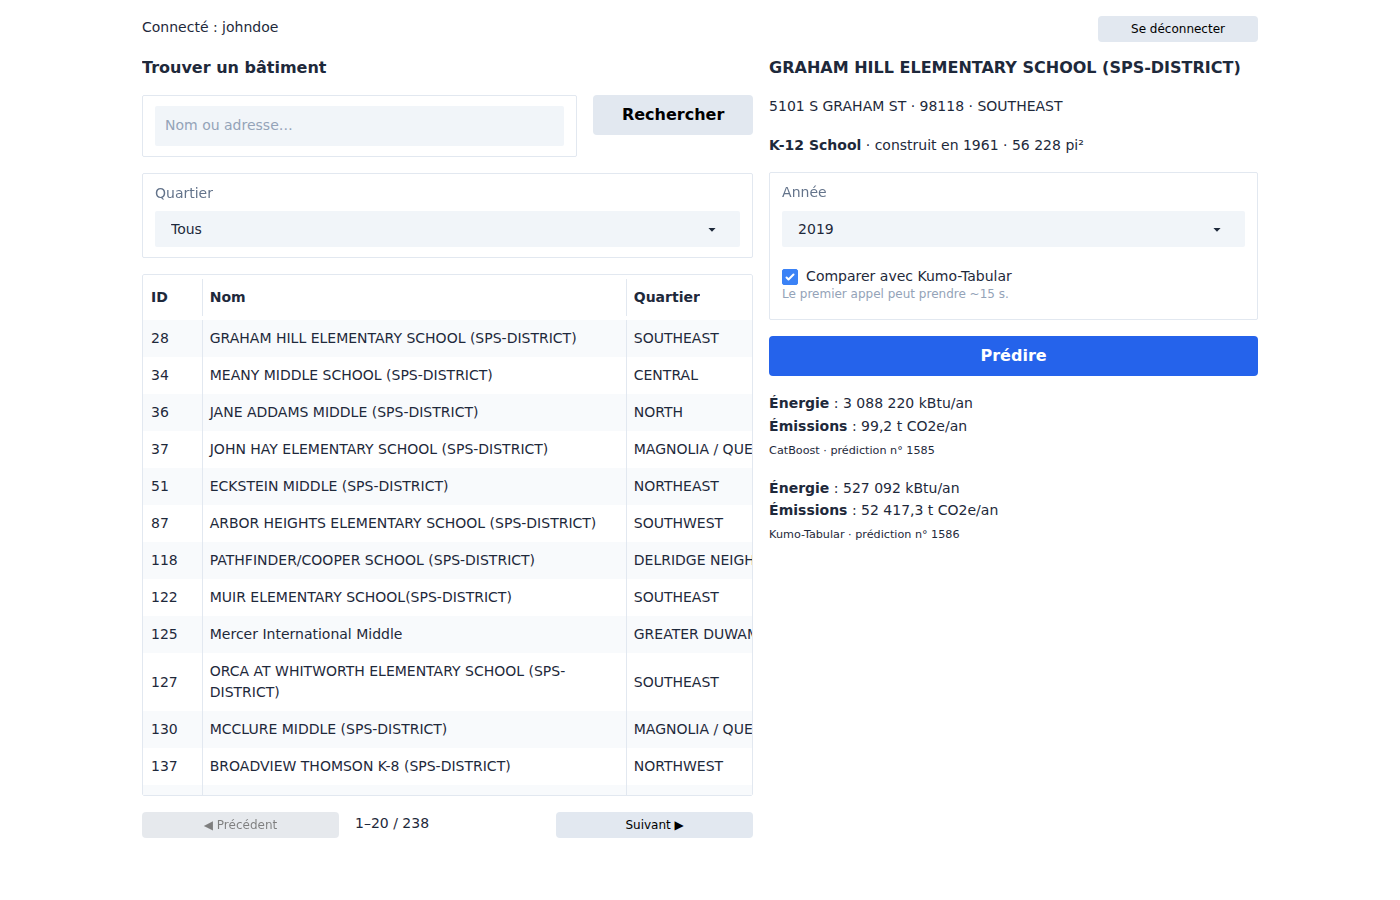
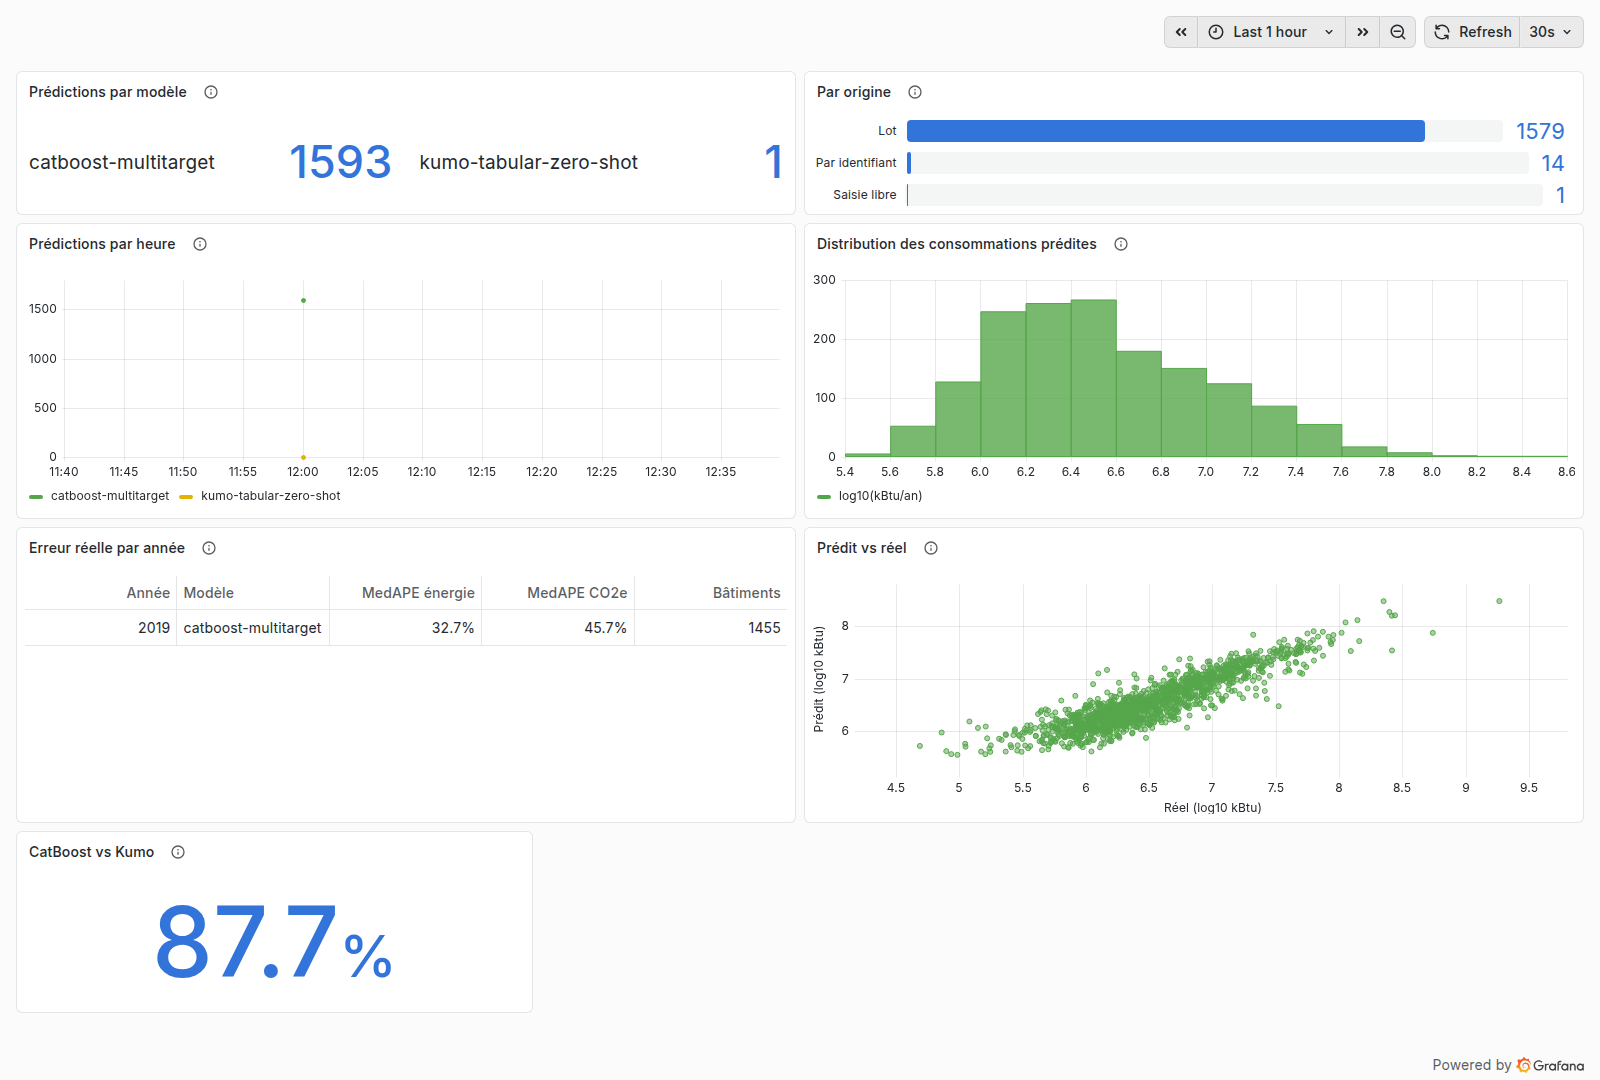
Le scénario : un client veut rendre son modèle « utilisable en production ». J'ai livré une API FastAPI authentifiée par JWT, adossée à PostgreSQL. Chaque appel et chaque prédiction y sont tracés, avec la version du modèle qui l'a produite. Les entraînements sont suivis dans MLflow, et deux tableaux de bord Grafana lisent la même base. Une interface Gradio sert de démonstration. La CI bloque une fusion si les tests, la sécurité ou la performance du modèle régressent par rapport à la version de référence.
CSV 2016 + open data 2017–2019 ─▶ ingestion (nettoyage, harmonisation, split)
                                      │
                                      ▼
                                 PostgreSQL ◀── MLflow (runs, métriques, artefacts)
                                 │   ▲   ▲
             entraînement ◀──────┘   │   └── Grafana (API, modèle)
     CatBoost ×2 + contexte Kumo     │
                    │                │ traçabilité : requêtes, prédictions, versions
                    ▼                │
          FastAPI (JWT) ─────────────┘ ◀── Gradio (démo)
          /model/predict           CatBoost, quelques ms
          /model/predict/compare   CatBoost + Kumo-Tabular, ~25 s
Le code est sur GitHub, le modèle CatBoost sur Hugging Face et une démo tourne en ligne.
Deux façons de prédire
CatBoost suit le chemin classique. On l'entraîne sur 1 236 bâtiments de 2016 (17 variables : type, quartier, surfaces, année de construction, raccordement au gaz naturel ou au réseau de chaleur urbain), avec validation croisée et recherche d'hyperparamètres. Une fois entraîné, il tient dans deux fichiers .cbm et répond en moins d'une milliseconde.
Kumo-Tabular ne s'entraîne pas. Il a été préentraîné une fois pour toutes, et il prédit par in-context learning : on lui passe des lignes étiquetées (le contexte) avec les lignes à prédire, et il raisonne par analogie, sans modifier ses poids. Son contexte, ici, c'est exactement le jeu d'entraînement de CatBoost. Les deux modèles voient donc les mêmes données, et aucun bâtiment de test.
Les scores
- CatBoost (entraîné)
- Kumo-Tabular (contexte)
| Cible | Modèle | R² | MAE | Erreur relative médiane |
|---|---|---|---|---|
| Énergie | CatBoost | 0,24 | 5,17 M kBtu | 35,0 % |
| Énergie | Kumo-Tabular | 0,45 | 4,71 M kBtu | 35,1 % |
| Émissions | CatBoost | 0,11 | 145,9 t CO2e | 43,7 % |
| Émissions | Kumo-Tabular | 0,21 | 136,6 t CO2e | 48,3 % |
Sur le papier, Kumo gagne nettement en R² et en erreur absolue, des métriques dominées par les grands bâtiments. En erreur relative médiane, qui pèse autant un petit bâtiment qu'un grand, il fait jeu égal sur l'énergie et moins bien sur les émissions. J'en avais conclu que Kumo extrapolait mieux sur la queue de la distribution. Restait à savoir si l'écart tenait.
Ce que valent ces scores
Un seul bâtiment fait le résultat. Sur l'énergie, cinq bâtiments concentrent 96 à 97 % de l'erreur quadratique des deux modèles, et un seul en porte 65 à 76 %. C'est un site industriel classé « campus », avec une centrale énergétique et des laboratoires : il consomme 448 M kBtu, CatBoost en prédit 36 M, Kumo 63 M. Les deux le ratent. Le deuxième est un data center : 275 M kBtu réels, 32 M pour CatBoost, 175 M pour Kumo. Celui-là, Kumo s'en approche.
| Bâtiments retirés du test (énergie) | R² CatBoost | R² Kumo |
|---|---|---|
| aucun | 0,24 | 0,43 |
| le site industriel | 0,39 | 0,69 |
| le data center | 0,25 | 0,32 |
| les deux | 0,58 | 0,53 |
Sans ces deux bâtiments sur 310, CatBoost repasse devant. Sur les émissions, retirer le site industriel, le data center et un hôpital suffit à mettre les deux modèles à égalité (R² 0,55 partout, erreur absolue 72 contre 71 t CO2e). L'avance de Kumo tient donc à sa façon de traiter quelques bâtiments extrêmes. Ce n'est pas rien : ce sont eux qui pèsent dans le bilan énergétique d'une ville. Mais c'est une preuve fragile.
Le bootstrap le confirme. Sur 2 000 rééchantillonnages appariés du jeu de test, l'intervalle de confiance à 95 % du R² de CatBoost sur l'énergie va de 0,16 à 0,75, celui de Kumo de 0,26 à 0,81. L'écart entre les deux va de −0,23 à +0,52 : il n'est pas significatif. Kumo a le meilleur R² dans 90 % des tirages pour l'énergie et 94 % pour les émissions. La tendance est cohérente, sans être établie. Sur l'erreur relative médiane des émissions, c'est l'inverse : CatBoost est meilleur dans 92 % des tirages.
Kumo ne donne pas deux fois le même score. Son inférence tire des échantillons au hasard, et le service ne fixe pas de graine. Sur cinq graines, avec le même contexte, son R² sur l'énergie varie de 0,42 à 0,46. Le 0,45 publié est un tirage parmi d'autres.
Le contexte, c'est le modèle
La première version de la comparaison utilisait un contexte synthétique : quelques lignes générées, avec des émissions fixées à 0,1 fois l'énergie. À Seattle, le vrai ratio est d'environ 0,00002 t CO2e par kBtu. Kumo reste proche des valeurs qu'il voit en contexte. Il a donc prédit des émissions environ 500 fois trop élevées, avec un R² de −1 829.
Le correctif n'a pas touché au modèle, seulement aux données : le contexte est devenu le jeu d'entraînement réel, exporté par le pipeline et versionné avec les modèles. C'est la leçon la plus concrète du projet. Avec un modèle à in-context learning, le feature engineering devient du context engineering : quelles lignes donner, avec quelle représentativité, sans quelle fuite. Et le MLOps ne disparaît pas, il se déplace : on ne versionne plus des poids, on versionne un jeu de données.
Ce que coûte une prédiction
Mon intuition de départ : « le dataset est rechargé à chaque inférence, donc le coût explose avec le volume ». Je l'ai mesurée avec les modèles livrés, sur CPU, 4 threads.
- CatBoost
- Kumo-Tabular (contexte de 1 236 lignes)
Mon intuition était à moitié juste. Le coût de Kumo dépend surtout de la taille du contexte, pas du nombre de prédictions. Une ligne coûte 25,5 s, mille lignes 42,5 s : 42 ms par bâtiment en lot. Le problème n'est donc pas le volume de données à prédire, c'est le nombre d'appels. Un usage en lot amortit le contexte. Un usage temps réel, une requête à la fois comme dans mon API, le paie à chaque fois. Et la durée d'un appel croît à peu près linéairement avec la taille du contexte (section suivante).
L'autre levier, c'est de réduire le contexte. La documentation du projet annonçait un R² de 0,49 avec un échantillon de 300 lignes, mieux qu'avec tout le jeu. C'était un tirage favorable : sur trois autres tirages, j'obtiens 0,31 à 0,37. J'ai aussi testé l'idée d'un « RAG tabulaire » : donner à Kumo, pour chaque bâtiment à prédire, ses 300 voisins les plus proches dans le jeu d'entraînement.
| Contexte de Kumo | R² énergie | Erreur médiane énergie | R² émissions | Erreur médiane émissions |
|---|---|---|---|---|
| 300 lignes au hasard (3 tirages) | 0,31 à 0,37 | 42 % | 0,17 à 0,26 | 54 % |
| 300 plus proches voisins | 0,38 | 38 % | 0,21 | 49 % |
| 1 236 lignes (tout l'entraînement) | 0,42 à 0,46 | 34 % | 0,20 à 0,21 | 49 % |
À taille égale, les voisins battent le hasard sur toutes les métriques, sans rattraper le contexte complet sur l'énergie. Le compromis dépend de l'usage. Pour une requête unitaire, 300 voisins coûtent environ 6 s au lieu de 25 s. En lot, c'est l'inverse : un contexte par bâtiment empêche de mutualiser, et prédire les 310 bâtiments prend une demi-heure au lieu d'une minute.
Même optimisé, l'écart reste énorme : à l'unité, environ 30 000 fois la latence de CatBoost. Pour une API qui sert des milliers de requêtes par seconde, la question ne se pose pas.
Et avec plus de données ?
Les modèles de fondation tabulaires sont réputés forts sur les petits jeux de données. Il fallait donc chercher le point où CatBoost repasse devant. J'ai fait varier la taille du jeu d'entraînement, qui sert aussi de contexte à Kumo, de 100 à 4 700 lignes. Au-delà des 1 236 bâtiments de 2016, j'ai ajouté les années 2017 à 2019, sans jamais inclure un bâtiment du test. Le test reste les mêmes 310 bâtiments. Chaque point est la moyenne de trois tirages.
- CatBoost
- Kumo-Tabular
| Lignes | Erreur médiane énergie (CatBoost / Kumo) | Erreur médiane émissions (CatBoost / Kumo) | Durée d'un appel Kumo |
|---|---|---|---|
| 100 | 47 % / 54 % | 55 % / 71 % | 16 s |
| 300 | 39 % / 42 % | 49 % / 54 % | 20 s |
| 600 | 37 % / 37 % | 46 % / 51 % | 30 s |
| 1 236 | 34 % / 34 % | 44 % / 49 % | 59 s |
| 2 500 | 34 % / 34 % | 44 % / 47 % | 117 s |
| 4 700 | 34 % / 37 % | 45 % / 48 % | 225 s |
Je n'ai pas trouvé de croisement en R² : Kumo reste devant à toutes les tailles. Mais ce R² repose sur les quelques bâtiments extrêmes vus plus haut. Sur l'erreur médiane, le tableau dit autre chose. Avec peu de données, c'est CatBoost qui fait la meilleure prédiction typique : à 100 lignes, son erreur médiane sur les émissions est de 55 %, contre 71 % pour Kumo. L'idée que Kumo domine avec peu de données n'est vraie que pour les cas extrêmes.
Au-delà de 1 236 lignes, Kumo ne gagne plus rien, alors que la durée d'un appel continue de croître linéairement, d'environ 48 ms par ligne de contexte. Réserve : les lignes ajoutées sont surtout d'autres années des mêmes bâtiments, donc peu d'information nouvelle. Et CatBoost garde les hyperparamètres réglés pour 1 236 lignes, sans réglage par taille.
Alors, à quoi sert un modèle comme Kumo ?
C'était ma vraie question. Monter une chaîne d'entraînement XGBoost ou CatBoost est devenu facile, et un agent de code le fait en quelques minutes. Si le seul avantage de Kumo est d'éviter l'entraînement, il ne pèse pas lourd.
Mais l'entraînement n'est qu'une partie du coût. Ce projet me l'a montré : MLflow, gate de performance en CI, versions de modèle en base, redémarrage de l'API après réentraînement. Le coût réel d'un modèle, c'est son cycle de vie. Un modèle à in-context learning devient intéressant là où ce cycle de vie coûte plus que l'inférence :
| Situation | Pourquoi l'in-context learning tient la route |
|---|---|
| Démarrage à froid : quelques centaines d'exemples étiquetés | Ici, il capte mieux les cas extrêmes, mais sa prédiction typique est moins bonne que celle de CatBoost |
| Beaucoup de petits problèmes : un modèle par client, site ou région | Un seul service et des contextes, au lieu de centaines de pipelines à réentraîner et surveiller |
| Étiquettes qui arrivent en continu | Une nouvelle ligne de contexte est prise en compte à l'appel suivant, sans réentraînement |
| Droit à l'oubli | Retirer une ligne du contexte suffit, alors qu'un modèle entraîné doit être réentraîné |
| Prédictions rares, en lot, à forte valeur | 25 s ne comptent pas pour un audit énergétique annuel. C'est d'ailleurs le cas de ce jeu de données |
| Baseline sur des données à peine préparées | Une référence de qualité en minutes, pour décider si un pipeline dédié vaut l'effort |
À l'inverse, à fort volume de requêtes, avec des données stables et beaucoup d'étiquettes, un modèle entraîné gagne sur tous les plans. Le bon critère n'est pas « Kumo ou XGBoost » dans l'absolu. C'est le coût par appel multiplié par le nombre d'appels, face au coût de possession d'un pipeline d'entraînement.
Ce tableau est un raisonnement, pas une mesure. Seule la première ligne a été testée ici, et elle s'est révélée plus nuancée que prévu.
Ce qui reste au métier
Si l'entraînement devient une commodité, il reste deux choses que ni CatBoost ni Kumo ne font à notre place.
Connaître les données. Le bug du contexte synthétique en est l'exemple. Ce n'était pas un problème de modèle, c'était un ratio physique faux. L'harmonisation des années 2017–2019 en est un autre. L'open data de Seattle n'a pas le schéma du CSV 2016 : il a fallu reconstituer des colonnes en croisant 3 194 bâtiments communs, puis filtrer des déclarations aberrantes pourtant marquées conformes (un bâtiment déclare 278 fois sa consommation de l'année précédente). Sans ce travail, le R² d'une année entière s'effondre.
Interpréter les résultats. CatBoost offre une importance des variables native et des valeurs SHAP exactes, grâce à sa structure d'arbres. Kumo n'a rien de tel. Il faut une méthode agnostique : l'importance par permutation. On mélange une variable entre les bâtiments de test et on mesure combien l'erreur augmente. Grâce au traitement en lot, c'est faisable : 17 variables, 3 permutations, 2 cibles, environ une heure de calcul.
- CatBoost
- Kumo-Tabular
- CatBoost
- Kumo-Tabular
Les deux modèles s'accordent sur l'essentiel : la surface d'abord, puis l'usage du bâtiment. Ils divergent sur la variable qui décrit cet usage. CatBoost s'appuie sur le type de bien, Kumo sur l'usage principal. Ces deux colonnes se recoupent, sauf pour certains bâtiments. Le data center du test est classé « Other » en type de bien et « Data Center » en usage principal. CatBoost le voit comme un « autre », Kumo comme un data center, et c'est sur ce bâtiment que Kumo fait son avance. Kumo répartit aussi l'importance sur plus de variables : surface du deuxième usage, parking, nombre d'étages.
Sur les émissions, le raccordement au gaz naturel arrive juste après la surface pour les deux modèles. Pour CatBoost, c'est même la première variable selon SHAP (28 % de l'importance, contre 27 % pour la surface). La vapeur urbaine pèse aussi. C'est cohérent avec la physique du problème : l'électricité de Seattle est majoritairement hydraulique, donc peu carbonée. Les émissions viennent surtout de la combustion, sur place pour le gaz ou dans les chaufferies du réseau de vapeur. Les modèles retrouvent ce que sait un énergéticien. C'est rassurant, et c'est aussi la limite de l'exercice : ils ne voient que ce que les variables décrivent.
Un modèle à contexte pourrait offrir une autre explication : « ce bâtiment ressemble à ceux-là ». Je n'ai pas trouvé comment Kumo-Tabular exposerait ces exemples influents.
Ce que je retiens
Ce qui reste ouvert
- Un jeu de test plus grand, ou une validation croisée par bâtiment, pour que trois bâtiments ne fassent plus le classement.
- Régler CatBoost à chaque taille de jeu, au lieu de réutiliser les hyperparamètres réglés pour 1 236 lignes.
- De vrais nouveaux bâtiments au-delà de 1 236 lignes, plutôt que d'autres années des mêmes.
- Des contextes par similarité mutualisés, partagés entre bâtiments proches, pour garder le gain des voisins sans perdre le traitement en lot.
Liens
- Code, documentation et décisions techniques : OC-P5 sur GitHub
- Modèle CatBoost publié : seattle-energy-catboost sur Hugging Face
- Démo en ligne : seattle-energy-demo
- Kumo-Tabular : NVIDIA structured-data-models
- Données : Building Energy Benchmarking, open data de Seattle
Sur la carte
- LLM Summarizer Trainerprojet
- OC-Ai-Engineer-P3projet
- Fashion Trend Intelligenceprojet