项目已交付
不训练也能预测
CatBoost 对阵 Kumo-Tabular,对象是西雅图建筑的能耗:一个表格基础模型似乎不用训练就做得更好,每次调用 25 秒。四个实验来验证,以及这对使用场景、成本,和留给本行的东西意味着什么。
· 时间:2026 年 10 月 8 日 → 18 日 · 阅读约 7 分钟
- 机器学习
- 表格基础模型
- MLOps
- CatBoost
- 部署
为了我 AI Engineer 课程的第五个项目,我要把一个机器学习模型部署到生产环境:一个 API、测试、数据库、监控。模型预测西雅图非住宅建筑的能耗和 CO2 排放。我训练了一个 CatBoost,然后把它和 Kumo-Tabular 对比——后者是 NVIDIA 的表格基础模型,不训练:它靠每次调用时喂给它的示例来预测。在这个数据集上,它似乎做得更好,每次调用 25 秒。随后我做了四个实验来验证我的假设:它们明显修正了这个初步结论。下面是我测到的,以及我从中得到的。
- Kumo-Tabular 在能耗上的 R²,未经训练,而 CatBoost 是 0.24
- 0.45
- 单单一栋建筑——一个数据中心——扛起了全部优势:去掉它,再去掉最大的工业场地,CatBoost 就反超了
- 1 / 310
- Kumo 在 CPU(4 线程)上做一次预测,而 CatBoost 是 0.8 ms
- 25.5 s
- Kumo 单次调用做 1,000 次预测:成本来自上下文,而不是行数
- 42.5 s
- 上下文构建不当时排放的误差:对 Kumo 来说,上下文扮演了模型的角色
- × 528
- 行上下文:CatBoost 仍在进步,Kumo 触顶,且比 1,236 行时贵近 4 倍
- 4,700
交付的项目
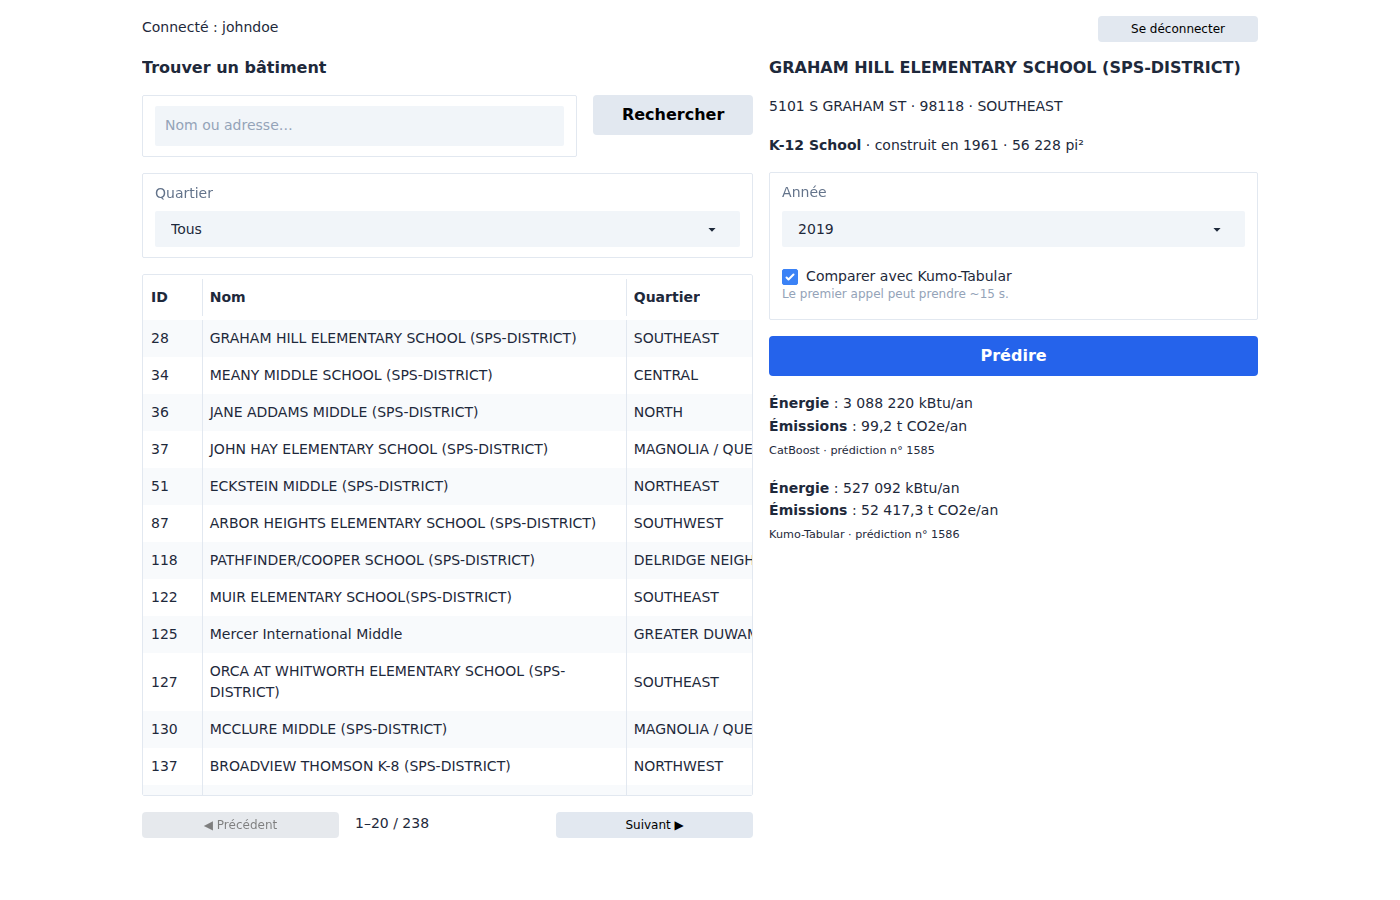
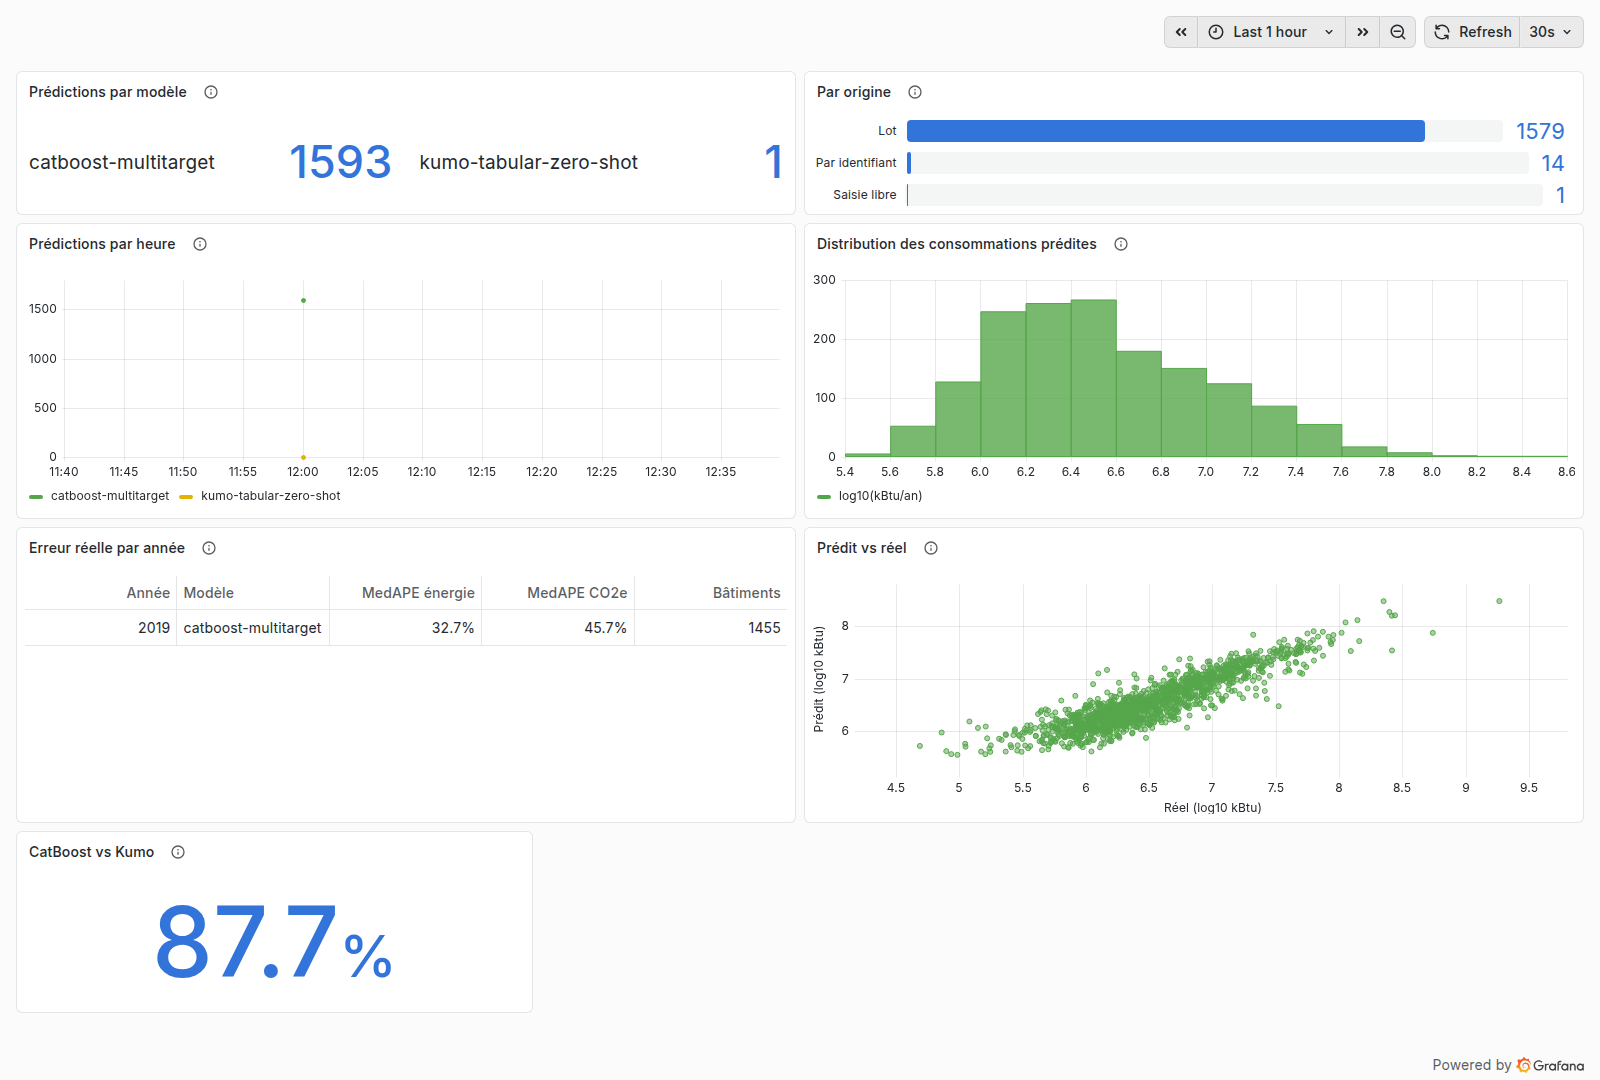
场景:客户想让他的模型「可用于生产」。我交付了一个用 JWT 认证、以 PostgreSQL 为后端的 FastAPI。每次调用、每次预测都被记录,连同产出它的模型版本。训练在 MLflow 里被跟踪,两个 Grafana 看板读同一个数据库。一个 Gradio 界面用作演示。如果测试、安全性或模型性能相对基准版本出现回归,CI 会阻止合并。
CSV 2016 + open data 2017–2019 ─▶ ingestion (清洗、对齐、切分)
                                      │
                                      ▼
                                 PostgreSQL ◀── MLflow (runs、指标、制品)
                                 │   ▲   ▲
                       训练 ◀──────┘   │   └── Grafana (API、模型)
     CatBoost ×2 + Kumo 上下文          │
                    │                │ 可追溯性:请求、预测、版本
                    ▼                │
          FastAPI (JWT) ─────────────┘ ◀── Gradio (演示)
          /model/predict           CatBoost,几毫秒
          /model/predict/compare   CatBoost + Kumo-Tabular,约 25 s
代码在 GitHub 上,CatBoost 模型在 Hugging Face 上,还有一个 演示 在线运行。
两种预测方式
CatBoost 走的是经典路线。用 2016 年的 1,236 栋建筑训练(17 个变量:类型、街区、面积、建造年份、是否接入天然气或城市供暖管网),带交叉验证和超参数搜索。训练完成后,它装在两个 .cbm 文件里,不到一毫秒就能给出答案。
Kumo-Tabular 不训练。它被一次性预训练好,然后通过 in-context learning 预测:把带标签的行(上下文)和要预测的行一起传给它,它靠类比推理,不改变自己的权重。在这里,它的上下文恰好就是 CatBoost 的训练集。所以两个模型看到的是同样的数据,且不含任何测试建筑。
分数
- CatBoost(已训练)
- Kumo-Tabular(上下文)
| 目标 | 模型 | R² | MAE | 相对误差中位数 |
|---|---|---|---|---|
| 能耗 | CatBoost | 0.24 | 5.17 M kBtu | 35.0% |
| 能耗 | Kumo-Tabular | 0.45 | 4.71 M kBtu | 35.1% |
| 排放 | CatBoost | 0.11 | 145.9 t CO2e | 43.7% |
| 排放 | Kumo-Tabular | 0.21 | 136.6 t CO2e | 48.3% |
纸面上,Kumo 在 R² 和绝对误差上明显胜出,而这两项指标被大建筑主导。在相对误差中位数上——它给一栋小建筑和一栋大建筑同等权重——它在能耗上打平,在排放上更差。我因此推断 Kumo 在分布尾部外推得更好。剩下的问题是:这个差距站得住吗?
这些分数值多少
一栋建筑决定了结果。 在能耗上,五栋建筑集中了两个模型 96 到 97% 的平方误差,其中一栋就占了 65 到 76%。那是一个被归为「campus」的工业场地,带一座能源站和若干实验室:它消耗 448 M kBtu,CatBoost 预测 36 M,Kumo 63 M。两个都没猜中。第二栋是一个数据中心:实际 275 M kBtu,CatBoost 32 M,Kumo 175 M。这一栋,Kumo 靠得比较近。
| 从测试中移除的建筑(能耗) | CatBoost R² | Kumo R² |
|---|---|---|
| 无 | 0.24 | 0.43 |
| 工业场地 | 0.39 | 0.69 |
| 数据中心 | 0.25 | 0.32 |
| 两者 | 0.58 | 0.53 |
310 栋里去掉了这两栋,CatBoost 就反超了。在排放上,去掉工业场地、数据中心和一家医院,就足以让两个模型打成平手(R² 处处 0.55,绝对误差 72 对 71 t CO2e)。所以 Kumo 的优势取决于它处理少数极端建筑的方式。这并非无关紧要:正是它们在城市能源账本里占了大头。但这是脆弱的证据。
bootstrap 证实了这一点。 对测试集做 2,000 次配对重采样,CatBoost 在能耗上 R² 的 95% 置信区间是 0.16 到 0.75,Kumo 是 0.26 到 0.81。两者的差距是 −0.23 到 +0.52:并不显著。在能耗上,90% 的抽取里 Kumo 的 R² 更好,排放上是 94%。趋势是一致的,但尚未确立。在排放的相对误差中位数上正好相反:92% 的抽取里 CatBoost 更好。
Kumo 不会两次给出同一个分数。 它的推理会随机抽样,而服务没有固定随机种子。用五个种子、同样的上下文,它在能耗上的 R² 在 0.42 到 0.46 之间波动。公布的 0.45 只是其中一次抽取。
上下文就是模型
对比的第一个版本用的是合成上下文:几行生成的数据,排放被固定为能耗的 0.1 倍。在西雅图,真实比值约为每 kBtu 0.00002 t CO2e。Kumo 会紧贴它在上下文里看到的值。于是它预测的排放高了约 500 倍,R² 为 −1,829。
修复没有碰模型,只改了数据:上下文变成了真实的训练集,由流水线导出,并随模型一起纳入版本管理。这是这个项目最具体的一课。对一个 in-context learning 模型,feature engineering 变成了 context engineering:给哪些行、代表性如何、避开哪种泄漏。而 MLOps 并没有消失,只是挪了位置:你不再对权重做版本管理,而是对一个数据集做版本管理。
一次预测的成本
我最初的直觉是:「数据集每次推理都要重新加载,所以成本会随数据量爆炸」。我用交付的模型测了它,CPU,4 线程。
- CatBoost
- Kumo-Tabular(1,236 行上下文)
我的直觉对了一半。Kumo 的成本主要取决于上下文的大小,而不是预测数量。一行要 25.5 s,一千行 42.5 s:批量下每栋建筑 42 ms。所以问题不是要预测的数据量,而是调用次数。批量使用摊薄了上下文的成本。实时使用——像我 API 里那样一次一个请求——每次都付这笔钱。而且一次调用的时长大致随上下文大小线性增长(见下一节)。
另一个杠杆是缩小上下文。项目文档声称用 300 行样本能到 R² 0.49,比用整个数据集还好。那是一次有利的抽取:另外三次抽取,我得到 0.31 到 0.37。我还试过「表格 RAG」的想法:对每一栋要预测的建筑,把它在训练集里最近的 300 个邻居给 Kumo。
| Kumo 的上下文 | 能耗 R² | 能耗误差中位数 | 排放 R² | 排放误差中位数 |
|---|---|---|---|---|
| 300 随机行(3 次抽取) | 0.31 到 0.37 | 42% | 0.17 到 0.26 | 54% |
| 300 个最近邻 | 0.38 | 38% | 0.21 | 49% |
| 1,236 行(全部训练集) | 0.42 到 0.46 | 34% | 0.20 到 0.21 | 49% |
在相同规模下,邻居在所有指标上都胜过随机,但在能耗上仍追不上完整上下文。取舍取决于用途。对单次请求,300 个邻居约需 6 s 而不是 25 s。批量下正好相反:每栋建筑一个上下文就无法复用,预测 310 栋建筑要半小时而不是一分钟。
即便优化后,差距依然巨大:单次调用约为 CatBoost 延迟的 30,000 倍。对一个每秒服务数千请求的 API,这个问题根本不用考虑。
数据更多会怎样?
表格基础模型以在小数据集上表现强著称。所以要找的是 CatBoost 反超的那个点。我把训练集大小——它同时也充当 Kumo 的上下文——从 100 行变到 4,700 行。在 2016 年的 1,236 栋建筑之外,我加入了 2017 到 2019 年,始终不包含任何测试建筑。测试仍是同样的 310 栋。每个点是三次抽取的平均。
- CatBoost
- Kumo-Tabular
| 行数 | 能耗误差中位数(CatBoost / Kumo) | 排放误差中位数(CatBoost / Kumo) | Kumo 一次调用时长 |
|---|---|---|---|
| 100 | 47% / 54% | 55% / 71% | 16 s |
| 300 | 39% / 42% | 49% / 54% | 20 s |
| 600 | 37% / 37% | 46% / 51% | 30 s |
| 1,236 | 34% / 34% | 44% / 49% | 59 s |
| 2,500 | 34% / 34% | 44% / 47% | 117 s |
| 4,700 | 34% / 37% | 45% / 48% | 225 s |
我找不到 R² 上的交叉:Kumo 在所有规模上都领先。但这个 R² 依赖前面看到的少数极端建筑。在误差中位数上,表格说的是另一回事。数据少时,反而是 CatBoost 做出更好的典型预测:100 行时,它在排放上的误差中位数是 55%,而 Kumo 是 71%。Kumo 在数据少时占优这个说法,只对极端情况成立。
超过 1,236 行,Kumo 再也挣不到好处,而一次调用的时长仍在近乎线性地增长,每行上下文约 48 ms。注意:新增的行大多是同一批建筑的其他年份,所以新信息很少。而且 CatBoost 沿用为 1,236 行调好的超参数,没有按规模重新调参。
那么,像 Kumo 这样的模型有什么用?
这才是我的真问题。搭一条 XGBoost 或 CatBoost 的训练链已经变得很容易,一个代码智能体几分钟就能搞定。如果 Kumo 唯一的优势只是省掉训练,那它分量不重。
但训练只是成本的一部分。这个项目让我看到了:MLflow、CI 里的性能门禁、数据库里的模型版本、重训后重启 API。一个模型的真实成本是它的生命周期。当生命周期比推理更贵时,in-context learning 模型就变得有吸引力:
| 场景 | 为什么 in-context learning 站得住 |
|---|---|
| 冷启动:几百个带标签的示例 | 在这里它能更好地抓住极端情况,但它的典型预测不如 CatBoost |
| 大量小问题:每个客户、站点或地区一个模型 | 一个服务加若干上下文,而不是几百条要重训、要监控的流水线 |
| 标签持续到来 | 新增一行上下文在下次调用就生效,无需重训 |
| 被遗忘权 | 从上下文里删掉一行就够了,而训练过的模型必须重训 |
| 稀疏、批量、高价值的预测 | 25 s 对年度能源审计不算什么。这个数据集正是这种情况 |
| 在刚整理好的数据上做基线 | 几分钟得到一个质量参照,用来判断专用流水线值不值得投入 |
反过来,在请求量高、数据稳定、标签充足的情况下,训练过的模型在各方面都胜出。正确的标准不是抽象地问「Kumo 还是 XGBoost」,而是每次调用的成本乘以调用次数,对比一条训练流水线的持有成本。
这张表是推理,不是测量。这里只有第一行经过了测试,而它证明比预想的更微妙。
留给本行的东西
如果训练变成一种商品,那么还有两件事,CatBoost 和 Kumo 都不会替我们做。
了解数据。 合成上下文的 bug 就是例子。那不是模型问题,而是一个物理比值错了。2017–2019 年的对齐是另一个例子。西雅图的开放数据没有 2016 年 CSV 的 schema:我得靠 3,194 栋共同建筑来重建列,然后过滤掉那些虽然被标为合规、实则可疑的申报(有一栋建筑申报的能耗是上一年的 278 倍)。没有这份工作,整整一年的 R² 会崩掉。
解读结果。 CatBoost 因为树结构,天然提供变量重要性和精确的 SHAP 值。Kumo 什么都没有。需要一种与模型无关的方法:置换重要性。把某个变量在测试建筑之间打乱,测量误差涨了多少。借助批量处理,这可行:17 个变量、3 次置换、2 个目标,大约一小时计算。
- CatBoost
- Kumo-Tabular
- CatBoost
- Kumo-Tabular
两个模型在要点上一致:先是面积,然后是建筑的用途。它们在描述用途的那个变量上出现了分歧。CatBoost 依赖物业类型,Kumo 依赖主要用途。这两列基本重合,除了某些建筑。测试里的数据中心,在物业类型上是「Other」,在主要用途上是「Data Center」。CatBoost 把它看成一个「其他」,Kumo 把它看成数据中心,而 Kumo 的优势正是出在这栋建筑上。Kumo 还把重要性分摊到更多变量上:第二用途的面积、停车、楼层数。
在排放上,天然气接入在两个模型里都紧随面积之后。对 CatBoost 来说,按 SHAP 它甚至是第一变量(占重要性 28%,面积 27%)。城市蒸汽也有分量。这与问题的物理相符:西雅图的电力以水电为主,因此碳排低。排放主要来自燃烧,天然气在现场烧,蒸汽则在管网的锅炉房里烧。模型重新发现了能源工程师本就熟悉的东西。这让人安心,也是这项练习的局限:它们只看得见变量所描述的东西。
基于上下文的模型或许能提供另一种解释:「这栋建筑像那几栋」。我没找到 Kumo-Tabular 会如何把这些有影响的示例暴露出来。
我从中得到什么
仍然开放的问题
- 更大的测试集,或者按建筑做交叉验证,让三栋建筑不再决定排名。
- 在每个数据集规模上重新调 CatBoost,而不是沿用为 1,236 行调好的超参数。
- 真正的新建筑,而不是超过 1,236 行后同一批建筑的其他年份。
- 按相似度共享的上下文,在相近建筑之间复用,既保留邻居带来的增益又不失批量处理。
链接
- 代码、文档和技术决策:GitHub 上的 OC-P5
- 已发布的 CatBoost 模型:Hugging Face 上的 seattle-energy-catboost
- 在线演示:seattle-energy-demo
- Kumo-Tabular:NVIDIA structured-data-models
- 数据:西雅图开放数据 Building Energy Benchmarking